卡片索引
| 卡片 | 类型 | 说明 |
|---|---|---|
| 为什么需要主从复制 | 概念卡 | 为什么要做主从复制? |
| 主从复制是什么 | 概念卡 | 主从复制是什么?核心概念一览 |
| 全量复制 vs 部分复制 | 概念卡 | 全量复制 vs 部分复制(PSYNC) |
| 5 分钟搭建一主一从 | 操作卡 | 5 分钟搭建一主一从 |
| 核心配置参数 | 参考卡 | 主从复制核心配置参数速查 |
| 常见问题与排查 | 故障卡 | 常见问题与排查 |
| 用"图书馆"理解主从复制 | 类比卡 | 费曼技巧:用"图书馆"理解主从复制 |
概念卡:为什么要做主从复制?
一句话:单机 Redis 有三座大山——故障、容量、QPS。主从复制是翻越这三座山的第一步。
单机 Redis 的三大问题
| 问题 | 表现 | 本质 |
|---|---|---|
| 单点故障 | 机器挂了,所有客户端连不上 Redis | 高可用问题 |
| 容量瓶颈 | 16G 内存的机器放不下 64G 数据 | 分布式存储问题 |
| QPS 瓶颈 | 单机扛不住 100W QPS(号称 10W) | 分布式读扩展问题 |
关键洞察:容量和 QPS 瓶颈是分布式要解决的问题,而故障是高可用要解决的问题。主从复制同时回应了这三个问题。
主从复制能做什么
- 数据备份:一份数据,多个副本,不怕单点挂掉
- 读写分离:写走 Master,读走 Replica,扩展读性能
- 故障转移基础:主从是哨兵(Sentinel)和 Cluster 的前提
核心规则
- 一个 Master 可以有多个 Replica
- 一个 Replica 只能有一个 Master
- 数据流向是单向的:Master → Replica
相关卡片
- → #概念卡:主从复制是什么 主从复制整体概念
- → #操作卡:5 分钟搭建一主一从 动手搭建
- → #类比卡:用"图书馆"理解主从复制 用类比理解
概念卡:主从复制是什么?
一句话:Master 把数据"复印"给 Replica,Replica 是只读的副本。
拓扑结构
                    ┌─────────────┐
                    │   Master    │  ← 读写
                    │  (6379)     │
                    └──────┬──────┘
                           │ 数据单向流动
               ┌───────────┼───────────┐
               ▼           ▼           ▼
        ┌──────────┐ ┌──────────┐ ┌──────────┐
        │ Replica 1│ │ Replica 2│ │ Replica 3│  ← 只读
        │ (6380)   │ │ (6381)   │ │ (6382)   │
        └──────────┘ └──────────┘ └──────────┘
两种同步方式
| 方式 | 触发条件 | 特点 |
|---|---|---|
| 全量复制 (Full Resync) | 首次连接、Master 重启(run_id 变化)、断连超时超出 repl_backlog | 传整个 RDB,开销大 |
| 部分复制 (Partial Resync) | 短暂断连且在 repl_backlog 范围内 | 只传断连期间的命令,开销小 |
决定用哪种的关键:PSYNC 命令(见 #概念卡:全量复制 vs 部分复制)
核心概念速查
| 术语 | 含义 |
|---|---|
run_id | 每个 Redis 实例启动时随机生成的唯一标识,重启后变化 |
master_repl_offset | 主节点已写入的总字节数,代表"写到哪了" |
slave_repl_offset | 从节点已同步的总字节数 |
repl_backlog | 主节点维护的一个环形缓冲区,缓存最近写入的命令,用于部分复制 |
master_link_status | 主从连接状态,up = 正常,down = 异常 |
相关卡片
- ← #概念卡:为什么要做主从复制 为什么需要
- → #概念卡:全量复制 vs 部分复制 全量 vs 部分复制详解
- → #操作卡:5 分钟搭建一主一从 动手搭建
概念卡:全量复制 vs 部分复制(PSYNC)
一句话:Redis 用 PSYNC 命令决定是"全盘托出"还是"只补遗漏"。
PSYNC 命令的两个参数
PSYNC <run_id> <offset>
| 参数 | 含义 | 首次同步时传什么? |
|---|---|---|
run_id | 我知道的 Master 的 ID | ?(不知道) |
offset | 我知道的 Master 的偏移量 | -1(不知道) |
全量复制流程(Full Resync)
Replica                          Master
  │                                │
  │────── PSYNC ? -1 ────────────►│   // "我不认识你,从头来吧"
  │                                │
  │                                │←── BGSAVE(生成 RDB 快照)
  │                                │←── 同时记录后续写入命令到 repl_backlog
  │◄───── 传输 RDB 文件 ──────────│
  │                                │
  │◄──── 传输 backlog 中的命令 ───│  // RDB 生成后到传输期间的新命令
  │                                │
  │── 清空旧数据 + 加载 RDB ──────►│  // 在内存中重建数据
  │                                │
  │══════ 同步完成 ═══════════════│
关键点:
- Master 执行
BGSAVE生成 RDB 快照 - 在 RDB 生成到传输完成期间,Master 把所有新写入的命令存进
repl_backlog - RDB 传完后,再把 backlog 中的命令补传给 Replica
- 这样就保证了"全量 + 增量"的无缝衔接
部分复制流程(Partial Resync)
Replica                          Master
  │                                │
  │◄──── 短暂断连(< repl_backlog)─│
  │                                │
  │────── PSYNC <run_id> <offset>─►│  // "我记得你,只补这段"
  │                                │
  │◄──── 只传 backlog 中的命令 ───│  // 不需要传 RDB
  │                                │
  │══════ 同步完成 ═══════════════│
前提条件:
- Replica 记住了 Master 的
run_id - 断连时间不超过
repl_backlog_size的容量 - Master 没有重启(run_id 没变)
什么时候触发全量?什么时候触发部分?
| 场景 | 类型 | 原因 |
|---|---|---|
| 首次连接 | 全量 | Replica 不知道 Master 的 run_id |
| Master 重启 | 全量 | run_id 变了,Replica 认为换了个 Master |
| 断连时间短 | 部分 | repl_backlog 里还有数据 |
| 断连时间长 | 全量 | repl_backlog 已过期被覆盖 |
| 网络抖动恢复 | 部分 | 通常在 backlog 范围内 |
全量复制的开销
做一次全量复制,Master 和 Replica 都要付出代价:
- Master 侧:
BGSAVEfork 子进程的 CPU 开销 + CoW 内存开销 - 网络:RDB 文件传输时间(数据量大时可能几分钟)
- Replica 侧:清空旧数据 + 加载 RDB 到内存
- 可能触发:AOF 重写(如果
repl-backlog-sync期间触发了auto-aof-rewrite)
经验法则:全量复制适合初次同步或小数据量场景。大数据量时考虑增量复制或优化 RDB 传输方式(diskless sync)。
相关卡片
- ← #概念卡:主从复制是什么 同步方式概览
- → #类比卡:用"图书馆"理解主从复制 用类比理解
- → #故障卡:常见问题与排查 同步失败怎么办
操作卡:5 分钟搭建一主一从
一句话:改两个配置文件,启动两个进程,完事。
前置条件
假设你已经完成了 Redis 安装,源码在 /opt/redis-stable,二进制在 /usr/local/redis/bin/。
如果没有,先看 → #参考卡:主从复制核心配置参数 配置速查
Step 1:创建目录结构
cd /opt/redis-stable
mkdir -p config data
Step 2:Master 配置(6379)
cp redis.conf config/redis-6379.conf
vim config/redis-6379.conf
关键配置项:
daemonize yes
port 6379
logfile "/opt/redis-stable/data/6379.log"
dbfilename "dump-6379.rdb"
dir "/opt/redis-stable/data"
# 生产环境建议加上:
# bind 127.0.0.1
# protected-mode yes
# requirepass YOUR_PASSWORD
Step 3:Replica 配置(6380)
cp config/redis-6379.conf config/redis-6380.conf
vim config/redis-6380.conf
关键配置项(在 6379 基础上修改):
port 6380
logfile "/opt/redis-stable/data/6380.log"
dbfilename "dump-6380.rdb"

# 声明主节点
replicaof 127.0.0.1 6379

# 如果主节点设置了密码,从节点也要配:
# replicaauth YOUR_PASSWORD

# 从节点只读(默认开启,显式确认)
replica-read-only yes
版本注意:Redis 5.0+ 用
replicaof,旧版本用slaveof,两者等价。
Step 4:启动
# 先启动 Master
redis-server config/redis-6379.conf

# 再启动 Replica
redis-server config/redis-6380.conf
Step 5:验证
# 查看 Master 状态
redis-cli -p 6379 info replication
# role:master
# connected_slaves:1

# 查看 Replica 状态
redis-cli -p 6380 info replication
# role:slave
# master_link_status:up

# 写数据验证
redis-cli -p 6379 set hello world
redis-cli -p 6380 get hello
# "world"  ← 同步成功!

# 验证只读
redis-cli -p 6380 set foo bar
# (error) READONLY You can't write against a read only replica.
动态修改主从关系(无需改配置文件)
# 让 6380 改挂到另一个 Master
redis-cli -p 6380 REPLICAOF 10.0.0.2 6379

# 解除主从关系,变回独立 Master
redis-cli -p 6380 REPLICAOF NO ONE
⚠️
REPLICAOF是异步命令,执行后 Replica 会断开与原 Master 的连接,重新连接新 Master。
相关卡片
- ← #概念卡:主从复制是什么 概念
- → #参考卡:主从复制核心配置参数 参数速查
- → #故障卡:常见问题与排查 遇到问题?
参考卡:主从复制核心配置参数
一句话:需要改什么配置?这张表就够了。
Master 侧参数
| 参数 | 默认值 | 说明 |
|---|---|---|
repl-backlog-size | 1MB | 部分复制的环形缓冲区大小 |
repl-backlog-ttl | 3600秒 | backlog 中无人使用时,多久后释放 |
min-replicas-to-write | 0 | Master 接受写入的最小从节点数(0=不限制) |
min-replicas-max-lag | 10秒 | 从节点最大延迟,超过此值 Master 拒绝写入 |
replica-announce-ip | 自动 | 向其他节点宣告的 IP(容器环境常用) |
replica-announce-port | 自动 | 向其他节点宣告的端口 |
Replica 侧参数
| 参数 | 默认值 | 说明 |
|---|---|---|
replicaof | 无 | master_ip master_port,声明主节点 |
replicaauth | 无 | 主节点密码(如果主节点开启了 requirepass) |
replica-read-only | yes | 从节点是否只读 |
replica-priority | 100 | 哨兵选举新 Master 的优先级(越低越优先) |
replica-serve-stale-data | yes | 断连时是否继续提供服务(yes=返回旧数据) |
replica-repl-diskless-sync | no | 是否启用无磁盘同步(直接网络传输 RDB) |
repl-diskless-sync | no | 全局:是否启用无磁盘同步 |
repl-diskless-sync-delay | 5秒 | 无磁盘同步前的等待延迟(等更多 Replica 一起连) |
常用诊断命令
# 查看复制状态(Master / Replica 都可用)
redis-cli INFO REPLICATION

# 查看 Master 的 run_id
redis-cli INFO SERVER | grep run_id

# 查看 Master 的详细日志
tail -f /opt/redis-stable/data/6379.log
INFO REPLICATION 关键字段解读
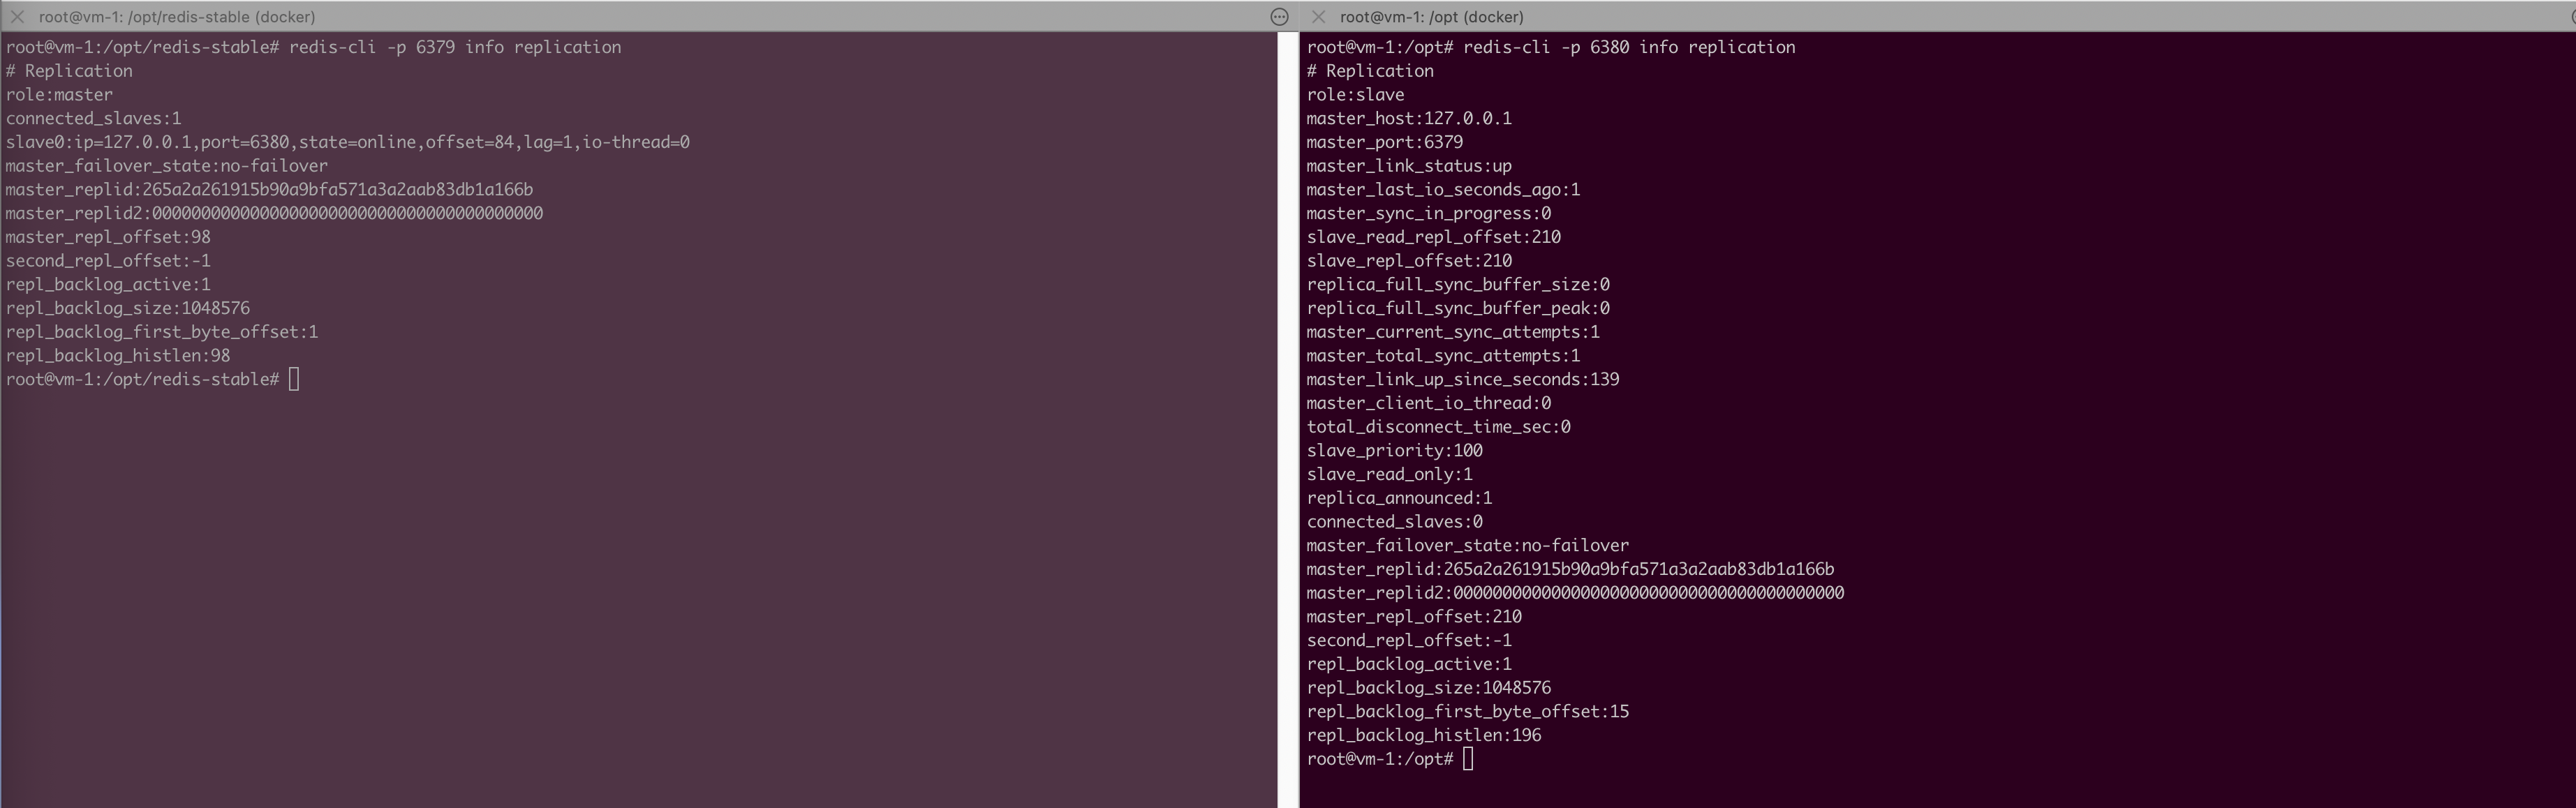
Master 输出:
role:master                  # 角色
connected_slaves:1           # 连接的从节点数
slave0:ip=127.0.0.1,port=6380,state=online,offset=5212,lag=1  # 从节点详情
master_repl_offset:5212      # 已同步的总偏移量
repl_backlog_active:1        # backlog 是否激活
repl_backlog_size:1048576    # backlog 大小
Replica 输出:
role:slave                   # 角色
master_host:127.0.0.1        # 主节点 IP
master_port:6379             # 主节点端口
master_link_status:up        # 连接状态
master_last_io_seconds_ago:4 # 上次 IO 距今秒数
master_sync_in_progress:0    # 是否正在全量同步
slave_repl_offset:5212       # 已同步偏移量
相关卡片
- ← #操作卡:5 分钟搭建一主一从 配置实践
- → #故障卡:常见问题与排查 参数调优与排错
故障卡:常见问题与排查
一句话:主从复制出问题,先看 INFO REPLICATION,再看日志。
问题 1:从节点连不上主节点
现象:master_link_status:down
排查步骤:
# 1. 检查网络
ping <master_ip>
telnet <master_ip> <master_port>

# 2. 检查主节点是否监听
redis-cli -h <master_ip> -p <master_port> PING

# 3. 检查主节点日志
tail -100 /opt/redis-stable/data/6379.log

# 4. 检查防火墙 / 安全组
常见原因:
- 主节点
bind配置限制了来源 IP protected-mode yes但未设密码- 防火墙阻断了端口
问题 2:全量复制反复触发
现象:日志中频繁出现 Full resync requested
排查:
# 检查 repl_backlog 是否太小
redis-cli INFO REPLICATION | grep repl_backlog

# 检查主从延迟
redis-cli INFO REPLICATION | grep lag
常见原因:
repl-backlog-size太小,增量数据被覆盖- 网络不稳定导致频繁断连
- 主节点数据量太大,RDB 传输时间过长
解决:增大 repl-backlog-size(默认 1MB,建议 64MB+)
问题 3:从节点写入报错
现象:
(error) READONLY You can't write against a read only replica.
这是正常行为。Replica 默认只读,不要在上面写数据。
如果需要让某个节点变回 Master:
redis-cli -p 6380 REPLICAOF NO ONE
⚠️ 执行后该节点会清空自己与主节点不一致的数据,重新同步。
问题 4:主节点宕机后的数据一致性
场景:Master 突然挂了,Replica 上有旧数据。
行为:
- Replica 在
replica-serve-stale-data yes(默认)时,断连期间继续服务旧数据 - 恢复连接后,会根据 run_id 判断是否全量同步
- 如果 Master 重启后 run_id 变化,Replica 会触发全量复制
建议:配合 #概念卡:全量复制 vs 部分复制 中的部分复制机制,缩短恢复时间。
问题 5:大 RDB 传输阻塞主节点
场景:数据量大时,BGSAVE fork 子进程 + 传输 RDB 消耗大量资源。
优化方案:
| 方案 | 配置 | 说明 |
|---|---|---|
| 无磁盘同步 | repl-diskless-sync yes | RDB 直接通过网络传输,不经磁盘 |
| 延迟同步 | repl-diskless-sync-delay 10 | 等 10 秒,让更多 Replica 一起加入,一次性传输 |
| 降低 fork 影响 | 增加内存、使用 SSD | 减少 CoW 开销 |
日志关键词速查
| 日志关键词 | 含义 |
|---|---|
Replica asks for synchronization | Replica 请求同步 |
Full resync requested | 全量复制请求 |
Partial resynchronization not possible | 无法部分复制,退化为全量 |
Background RDB transfer started | 开始传输 RDB |
MASTER <-> REPLICA sync: Finished with success | 同步成功 |
Connection with replica lost | 与 Replica 连接断开 |
相关卡片
- ← #操作卡:5 分钟搭建一主一从 搭建后出问题?
- → #参考卡:主从复制核心配置参数 参数调优
- → #概念卡:全量复制 vs 部分复制 理解 PSYNC 有助于排查
类比卡:用"图书馆"理解主从复制
一句话:主从复制就像图书馆馆长把藏书复印给分馆。
角色映射
| Redis 概念 | 图书馆类比 |
|---|---|
| Master | 总馆馆长,拥有唯一正版藏书 |
| Replica | 分馆管理员,只有复印件 |
| RDB 文件 | 整馆藏书目录的复印本 |
| repl_backlog | 馆长的小本子,记录最近借出去的书 |
| run_id | 馆长的工牌编号 |
| PSYNC | 分馆问:“我要你的书,是全馆目录还是要补借的书?” |
场景 1:新开分馆(全量复制)
分馆管理员第一天上班,问馆长:“把我的书给你。”
馆长说:“好,我先把你需要的全部藏书目录复印一遍(BGSAVE),然后给你送过去。”
复印期间有新读者借走了几本书,馆长在小本子上记下来(repl_backlog)。
送完目录后,馆长再把小本子上记的几本书的借阅信息补上。
分馆拿到完整目录后,清空自己空荡荡的书架,按照目录摆好书。
场景 2:分馆短暂离开又回来(部分复制)
分馆管理员出去吃了个午饭,回来问:“我走的时候你给了我到第 500 页,之后发生了什么?”
馆长翻开小本子一看:“哦,你走后我新增了 3 条借阅记录,给你。”
不需要重新复印整本目录,因为小本子(repl_backlog)里还记着。
场景 3:馆长换人了(run_id 变化)
分馆管理员回来,发现馆长换了——工牌编号(run_id)不一样了。
管理员心想:“这肯定是新馆长,我得要全套新书目。”
于是触发全量复制。旧馆长的复印本作废,重新来过。
场景 4:小本子写满了(backlog 溢出)
分馆管理员出去了三天才回来。
馆长的小本子只有 1MB,三天产生的借阅记录早就把旧记录覆盖了。
管理员:“那我走的时候到回来之间发生了什么?”
馆长:“对不起,小本子满了,旧记录没了。我只能给你复印全套新书目。”
解决方法:把小本子(
repl-backlog-size)换大一点。
核心原则
只读:分馆管理员不能改藏书目录,只能读。要改?去找总馆馆长。
单向:信息从总馆流向分馆,不会反向流动。
异步:馆长复印完目录通知分馆,不等分馆确认就继续接待读者。所以偶尔会有几秒延迟。
相关卡片
- ← #概念卡:主从复制是什么 概念
- → #概念卡:全量复制 vs 部分复制 PSYNC 详解