单机Redis存在的问题
什么是单机?就是在一台机器上部署一个Redis节点。
- 机器故障
但如果这台机器故障,该如何解决呢? 一旦该节点出现故障,则可能无法在短时间内恢复,客户端则无法连接Redis,严重会影响生产,这就是单机部署存在的问题。
- 容量瓶颈
加入一台机器16G内存,如果有个场景需要64G内存,单机可能无法满足,此时可能需要重新购买机器或扩充内存。
- QPS瓶颈
Redis 号称可以支持10W QPS,但是有个场景需要100W的QPS,该怎么做呢?容量瓶颈和QPS瓶颈实际上都是分布式要解决的问题,而机器故障则是高可用要解决的问题。
主从复制的基本作用
一主一从、一主多从。
- 备份。为一份数据提供多个副本。
- 读写分离。扩展读写性能。
Master 节点为主节点,Redis 还提供了叫Slave的节点称为从节点。
一主多从,一个Master节点可以有多个Slave节点,相当于有多个数据的副本,另外还可以做读写的分离。
- 为数据提供副本;
- 扩展读写性能;
- 一个Master可以有多个Slave;一个Slave只能有一个Master;
- 数据流量为单向,Master到Slave
主从配置
- slaveof 命令
- 参数配置方式
| 方式 | 命令 | 配置 |
|---|---|---|
| 优点 | 无需重启 | 统一配置 |
| 缺点 | 不便管理 | 需要重启 |
命令方式
比如希望6380的Redis服务成为6379服务的从节点,只需要在6380服务上执行 slaveof ip 6379 命令。这个命令是个异步命令
取消复制命令:如果不希望6380的Redis服务成为6379服务的从节点,而是作为一个主节点,可以执行 slaveof no one,此时他们的链接就会断开,之前的数据不会清除,而是新的数据不同再同步到6380服务。
修改配置
1. Master节点
- IP:127.0.0.1
- PORT:6379
编辑配置文件:
tar -xzf redis-stable.tar.gz -C /opt
mv redis-stable redis
cd /opt/redis
make -j$(nproc) && make PREFIX=/usr/local/redis install
mkdir -p config data

cp redis.conf config/redis-6379.conf
cd config
vim redis-6379.conf
主要配置修改如下,其他配置默认:
# cat redis-6379.conf | grep -v "#" | grep -v "^$"
# 1. 设置后台守护进程启动
daemonize yes
# 2. 设置启动文件
pidfile /var/run/redis-6379.pid
# 3. 配置端口
port 6379
# 4. 配置日志文件
logfile "6379.log"
# 5. 注释掉下面自动生成RDB配置
#save 900 1
#save 300 10
#save 60 10000
# 6. 配置dbfilename
dbfilename dump-6379.rdb
# 7. 设置数据目录
dir /opt/redis/data
2. Slave节点
- IP:127.0.0.1
- PORT:6380
- 配置:
cp redis-6379.conf redis-6380.conf
vim redis-6380.conf
主要配置修改如下,其他配置默认:
# cat redis-6380.conf | grep -v "#" | grep -v "^$"
# 1. 设置后台守护进程启动
daemonize yes
# 2. 设置启动文件
pidfile /var/run/redis-6380.pid
# 3. 配置端口
port 6380
# 4. 配置日志文件
logfile "6380.log"
# 5. 注释掉下面自动生成RDB配置
#save 900 1
#save 300 10
#save 60 10000
# 6. 配置dbfilename
dbfilename dump-6380.rdb
# 7. 设置数据目录
dir /opt/redis/data
# 8. 配置slave复制的master节点IP和Port,
# slaveof 127.0.0.1 6379
# Redis 从 5.0 版本开始,官方逐步用 replica(副本)代替了 slave(从机)
replicaof 127.0.0.1 6379
# 9. 从节点作只读节点,不做写操作(可选)
# slave-read-only yes
replica-read-only yes
首先启动6379代表的 Maste节点:
cd /opt/redis/config
redis-server redis-6379.conf
# ps -ef | grep redis- | grep -v grep
root     2393156       1 18 09:39 ?        00:00:09 redis-server *:6379

# 查看分片
# redis-cli
# 可以看到它是 master 角色的状态(role:master),连接的从节点目前是0个
127.0.0.1:6379> info replication
# Replication
role:master
connected_slaves:0
master_failover_state:no-failover
master_replid:e5276387e3a2d62bb6b183c94cd97315d8b8712f
master_replid2:0000000000000000000000000000000000000000
master_repl_offset:0
second_repl_offset:-1
repl_backlog_active:0
repl_backlog_size:1048576
repl_backlog_first_byte_offset:0
repl_backlog_histlen:0
127.0.0.1:6379>
再启动从节点:
redis-server redis-6380.conf
ps -ef | grep redis- | grep -v grep
root     2393156       1  5 09:39 ?        00:00:11 redis-server *:6379
root     2393166       1 70 09:43 ?        00:00:08 redis-server *:6380
# 查看slave节点分片信息
# 可以看到它是slave角色的状态,连接的主节点IP和Port是127.0.0.1和6379,以及和主节点的连接状态是up
redis-cli -p 6380 info replication
# Replication
role:slave
master_host:127.0.0.1
master_port:6379
master_link_status:up
master_last_io_seconds_ago:3
master_sync_in_progress:0
slave_read_repl_offset:42
slave_repl_offset:42
replica_full_sync_buffer_size:0
replica_full_sync_buffer_peak:0
master_current_sync_attempts:1
master_total_sync_attempts:1
master_link_up_since_seconds:18
master_client_io_thread:0
total_disconnect_time_sec:0
slave_priority:100
slave_read_only:1
replica_announced:1
connected_slaves:0
master_failover_state:no-failover
master_replid:5789eb8f7a7564ef4b025dd29e1002533ad353ab
master_replid2:0000000000000000000000000000000000000000
master_repl_offset:42
second_repl_offset:-1
repl_backlog_active:1
repl_backlog_size:1048576
repl_backlog_first_byte_offset:15
repl_backlog_histlen:28
3. 验证
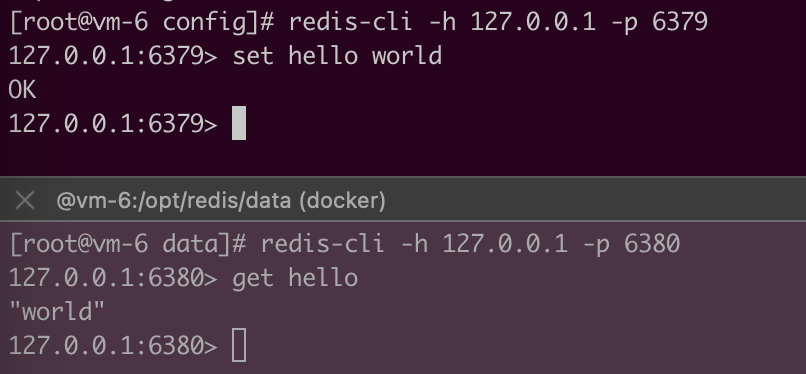
在主节点上设置一条数据,然后观察再从节点去查询这条数据:
# redis-cli -h 127.0.0.1 -p 6379
127.0.0.1:6379> set hello world
OK
127.0.0.1:6379> exit
# redis-cli -h 127.0.0.1 -p 6380
127.0.0.1:6380> get hello
"world"
# 从节点无法执行写入操作,只能读取
127.0.0.1:6380> set hello redis
(error) READONLY You can't write against a read only replica.
127.0.0.1:6380>
4. 查看日志
Master节点:
...
cat ../data/6379.log
6681:C 02 Jul 2026 18:37:03.092 * oO0OoO0OoO0Oo Redis is starting oO0OoO0OoO0Oo
6681:C 02 Jul 2026 18:37:03.093 * Redis version=8.6.0, bits=64, commit=00000000, modified=1, pid=6681, just started
6681:C 02 Jul 2026 18:37:03.093 * Configuration loaded
6681:M 02 Jul 2026 18:37:03.094 * monotonic clock: ARM CNTVCT @ 24 ticks/us
6681:M 02 Jul 2026 18:37:03.096 * Running mode=standalone, port=6379.
6681:M 02 Jul 2026 18:37:03.097 * Server initialized
6681:M 02 Jul 2026 18:37:03.097 * Ready to accept connections tcp
6681:M 02 Jul 2026 18:37:03.097 # WARNING: Redis does not require authentication. Redis will accept connections from any local client.
# ==> Slave 127.0.0.1:6380 要想做同步操作,也就是复制
6681:M 02 Jul 2026 18:39:34.191 * Replica 127.0.0.1:6380 asks for synchronization
6681:M 02 Jul 2026 18:39:34.191 * Full resync requested by replica 127.0.0.1:6380
6681:M 02 Jul 2026 18:39:34.191 * Replication backlog created, my new replication IDs are '5789eb8f7a7564ef4b025dd29e1002533ad353ab' and '0000000000000000000000000000000000000000'
6681:M 02 Jul 2026 18:39:34.191 * Replica 127.0.0.1:6380 is capable of rdb channel synchronization, and partial sync isn't possible. Full sync will continue with dedicated rdb channel.
6681:M 02 Jul 2026 18:39:34.192 * Replica 127.0.0.1:6380 asks for synchronization
# ==> 请求为全量同步请求,也就是全量复制
6681:M 02 Jul 2026 18:39:34.192 * Full resync requested by replica 127.0.0.1:6380 (rdb-channel)
6681:M 02 Jul 2026 18:39:34.192 * Delay next BGSAVE for diskless SYNC
6681:M 02 Jul 2026 18:39:39.918 * Starting BGSAVE for SYNC with target: replicas sockets (rdb-channel)
6681:M 02 Jul 2026 18:39:39.918 * Starting to deliver RDB and replication stream to replica: 127.0.0.1:6380
# ==> 接着master主节点会做一个bgsave操作,实际上就是生成一个RDB,将快照通过网络做同步
6681:M 02 Jul 2026 18:39:39.920 * Background RDB transfer started by pid 6700 to replica socket
6700:C 02 Jul 2026 18:39:39.921 * BGSAVE done, 0 keys saved, 0 keys skipped, 218 bytes written.
6700:C 02 Jul 2026 18:39:39.922 * Fork CoW for RDB: current 0 MB, peak 0 MB, average 0 MB
6681:M 02 Jul 2026 18:39:39.928 * Connection with replica (rdbchannel) 127.0.0.1:6380 lost.
6681:M 02 Jul 2026 18:39:39.928 * Synchronization with replica 127.0.0.1:6380 succeeded
6681:M 02 Jul 2026 18:39:40.023 * Background RDB transfer terminated with success
Slave节点:
...
2393166:S 13 Nov 09:43:08.168 * The server is now ready to accept connections on port 6380
# slave节点连接6379
2393166:S 13 Nov 09:43:08.168 * Connecting to MASTER 127.0.0.1:6379
# 主从复制开始
2393166:S 13 Nov 09:43:08.168 * MASTER <-> SLAVE sync started
2393166:S 13 Nov 09:43:08.168 * Non blocking connect for SYNC fired the event.
2393166:S 13 Nov 09:43:08.168 * Master replied to PING, replication can continue...
2393166:S 13 Nov 09:43:08.169 * Partial resynchronization not possible (no cached master)
# 做复制操作从节点就需要主节点的run id,可以通过执行 redis-cli -p 6379 info 查看master节点的run id
2393166:S 13 Nov 09:43:08.174 * Full resync from master: cb7f26f8a4b70e4c91524bd24486c69833f01018:1
# 从master节点多少字节,接收的就是rdb文件
2393166:S 13 Nov 09:43:11.884 * MASTER <-> SLAVE sync: receiving 247777833 bytes from master
# 只要是从节点去复制主节点,都会先做数据的清除
2393166:S 13 Nov 09:43:12.146 * MASTER <-> SLAVE sync: Flushing old data
# 加载rdb文件到内存,完成复制
2393166:S 13 Nov 09:43:12.146 * MASTER <-> SLAVE sync: Loading DB in memory
2393166:S 13 Nov 09:43:20.683 * MASTER <-> SLAVE sync: Finished with success

---
# ==> 上面是旧版本的复制
cat ../data/6380.log
6694:C 02 Jul 2026 18:39:34.186 * oO0OoO0OoO0Oo Redis is starting oO0OoO0OoO0Oo
6694:C 02 Jul 2026 18:39:34.186 * Redis version=8.6.0, bits=64, commit=00000000, modified=1, pid=6694, just started
6694:C 02 Jul 2026 18:39:34.186 * Configuration loaded
6694:S 02 Jul 2026 18:39:34.186 * monotonic clock: ARM CNTVCT @ 24 ticks/us
6694:S 02 Jul 2026 18:39:34.188 * Running mode=standalone, port=6380.
6694:S 02 Jul 2026 18:39:34.190 * Server initialized
6694:S 02 Jul 2026 18:39:34.190 * Ready to accept connections tcp
6694:S 02 Jul 2026 18:39:34.190 # WARNING: Redis does not require authentication. Redis will accept connections from any local client.
# ==> slave节点连接6379
6694:S 02 Jul 2026 18:39:34.190 * Connecting to MASTER 127.0.0.1:6379
# ==> 主从复制开始
6694:S 02 Jul 2026 18:39:34.190 * MASTER <-> REPLICA sync started
6694:S 02 Jul 2026 18:39:34.190 * Non blocking connect for SYNC fired the event.
6694:S 02 Jul 2026 18:39:34.191 * Master replied to PING, replication can continue...
6694:S 02 Jul 2026 18:39:34.191 * Partial resynchronization not possible (no cached master)
6694:S 02 Jul 2026 18:39:34.191 * PSYNC is not possible, initialize RDB channel.
6694:S 02 Jul 2026 18:39:39.919 * Starting to receive RDB and replication stream in parallel.
# ==> 从master节点多少字节,接收的就是rdb文件
6694:S 02 Jul 2026 18:39:39.922 * MASTER <-> REPLICA sync: receiving streamed RDB from master with EOF to disk
# ==> 加载rdb文件到内存,完成复制
6694:S 02 Jul 2026 18:39:39.922 * MASTER <-> REPLICA sync: Loading DB in memory
6694:S 02 Jul 2026 18:39:39.926 * MASTER <-> REPLICA sync: Flushing old data
6694:S 02 Jul 2026 18:39:39.927 * Loading RDB produced by version 8.6.0
6694:S 02 Jul 2026 18:39:39.927 * RDB age 0 seconds
6694:S 02 Jul 2026 18:39:39.927 * RDB memory usage when created 0.87 Mb
6694:S 02 Jul 2026 18:39:39.927 * Done loading RDB, keys loaded: 0, keys expired: 0.
6694:S 02 Jul 2026 18:39:39.927 * MASTER <-> REPLICA sync: Finished with success
6694:S 02 Jul 2026 18:39:39.927 * MASTER <-> REPLICA sync: Starting to stream replication buffer into the db (0 bytes).
6694:S 02 Jul 2026 18:39:39.927 * MASTER <-> REPLICA sync: Successfully streamed replication buffer into the db (0 bytes in total)
5. 移除主从关系
连接6380从节点,执行下面命令:
# redis-cli -p 6380
# 127.0.0.1:6380> slaveof no one
# 5.0 以上版本使用下面命令
127.0.0.1:6380> REPLICAOF NO ONE
OK
127.0.0.1:6380> info replication
# Replication
# 此时已取消主从关系变成了master
role:master
connected_slaves:0
master_failover_state:no-failover
master_replid:7f99a26545ef1f7138cec2d4054e47d4133cdfd6
master_replid2:5789eb8f7a7564ef4b025dd29e1002533ad353ab
master_repl_offset:1528
second_repl_offset:1529
repl_backlog_active:1
repl_backlog_size:1048576
repl_backlog_first_byte_offset:15
repl_backlog_histlen:1514

127.0.0.1:6380> exit
# 连接 6379 查看主从关系,已经没有了从节点
# redis-cli -p 6379
127.0.0.1:6379> info replication
# Replication
role:master
connected_slaves:0
master_failover_state:no-failover
master_replid:5789eb8f7a7564ef4b025dd29e1002533ad353ab
master_replid2:0000000000000000000000000000000000000000
master_repl_offset:1528
second_repl_offset:-1
repl_backlog_active:1
repl_backlog_size:1048576
repl_backlog_first_byte_offset:1
repl_backlog_histlen:1528
127.0.0.1:6379>

# 设置测试数据
127.0.0.1:6379> mset a b c d e f g h
OK
127.0.0.1:6379> dbsize
(integer) 5
127.0.0.1:6379> exit

[root@vm-6 data]# redis-cli -p 6380
127.0.0.1:6380> dbsize
(integer) 1
127.0.0.1:6380> flushdb
OK
(6.10s)
127.0.0.1:6380> set hello 6380
OK
127.0.0.1:6380>

# 执行建立主从复制关系后查看是否还存在上面设置的key
# 127.0.0.1:6380> slaveof 127.0.0.1 6379
127.0.0.1:6380> REPLICAOF 127.0.0.1 6379
OK
127.0.0.1:6380> get hello
(nil)
全量复制与部分复制
run_id
redis 每次启用的时候都会有一个随机的ID来作为Redis的标识,重启之后又会重新生成。
# redis-cli -p 6379 info server | grep run
run_id:b19c87443c8cf5bb4797800cd81fd4e080e16d00

# redis-cli -p 6380 info server | grep run
run_id:d8afb2262ce1b69876df9854bcf365614c2afde4
run_id 是个标识,比如6380去复制6379,6380会获取6379上的run_id作为自己的标识,但如果6380发现run_id发生了变化,就知道6379可能做了重启,就会将数据进行同步过来。
偏移量
# redis-cli -p 6379 info replication
# Replication
role:master
connected_slaves:1
slave0:ip=127.0.0.1,port=6380,state=online,offset=406,lag=1
# 这就是偏移量
master_repl_offset:406
repl_backlog_active:1
repl_backlog_size:1048576
repl_backlog_first_byte_offset:2
repl_backlog_histlen:405

# redis-cli -p 6379 set hello redis
OK
# redis-cli -p 6379 info replication
# Replication
role:master
connected_slaves:1
slave0:ip=127.0.0.1,port=6380,state=online,offset=469,lag=0
# 更新了一条数据后的偏移量
master_repl_offset:469
repl_backlog_active:1
repl_backlog_size:1048576
repl_backlog_first_byte_offset:2
repl_backlog_histlen:468

# redis-cli -p 6380 info replication
# Replication
role:slave
master_host:127.0.0.1
master_port:6379
master_link_status:up
master_last_io_seconds_ago:7
master_sync_in_progress:0
# 查看从节点的偏移量
slave_repl_offset:553
slave_priority:100
slave_read_only:1
connected_slaves:0
master_repl_offset:0
repl_backlog_active:0
repl_backlog_size:1048576
repl_backlog_first_byte_offset:0
repl_backlog_histlen:0

# redis-cli -p 6379 info replication
# Replication
role:master
connected_slaves:1
slave0:ip=127.0.0.1,port=6380,state=online,offset=609,lag=0
# 再查看主节点的偏移量已经发生了变化,实际上主从之间偏移量是个同步更新的状态,它们之间也会有一些操作,
# 从节点会向主节点做上报,会将从节点的状态同步给主节点,这样主节点就会知道从节点的偏移量
master_repl_offset:609
repl_backlog_active:1
repl_backlog_size:1048576
repl_backlog_first_byte_offset:2
repl_backlog_histlen:608
通过偏移量可以找到写入了多少数据。6379会将数据同步给6380,它也会知道偏移量。
全量复制开销
- bgsave的时间
- RDB文件在网络传输的时间
- 从节点清空数据的时间
- 从节点加载RDB的时间
- 可能的AOF重写时间
全量复制 部分复制
故障处理
主从结构出现故障如何转移?
- slave 宕机
小结
- 一个master可以有多个slave,一个slave 也可以有它自己的slave,那这个slave也就充当了master的角色
- 一个slave只能有一个master
- 数据流向为单向,master到slave