这是 Redis 持久化的卡片盒笔记集合。每张卡片独立成篇,卡片之间通过
#锚点互联。 遵循卢曼卡片盒笔记法:一张卡片 = 一个想法,用你自己的话写,像教别人一样。
卡片索引
| 卡片 | 类型 | 说明 |
|---|---|---|
| 什么是持久化 | 概念卡 | 持久化的定义与主流方式 |
| RDB 是什么 | 概念卡 | RDB 快照的原理与触发方式 |
| save vs bgsave | 对比卡 | 两种 RDB 触发命令的差异 |
| RDB 配置与实验 | 操作卡 | 配置参数 + 完整实验 |
| AOF 是什么 | 概念卡 | AOF 日志原理与刷盘策略 |
| AOF 重写 | 概念卡 | AOF 重写机制与触发条件 |
| AOF 演示 | 操作卡 | 开启 AOF + 查看文件 + 重写 |
| RDB vs AOF 选择 | 对比卡 | 何时用 RDB、何时用 AOF |
| fork 与子进程优化 | 故障卡 | fork 开销分析与优化方案 |
概念卡:什么是持久化?
一句话:Redis 数据在内存里,断电就没了。持久化就是把内存数据写到磁盘上,重启后能从磁盘恢复。
为什么需要持久化
Redis 把所有数据放在内存中,追求极致性能。但内存是易失的——进程崩溃、机器断电,数据就丢了。持久化解决的就是这个问题:
- 数据更新时,异步写入磁盘
- 磁盘数据在关机重启后依然存在
- 恢复时从磁盘加载到内存
主流数据库持久化方式
| 方式 | 原理 | 例子 |
|---|---|---|
| 快照 | 某时间点对数据的完整备份 | MySQL Dump、Redis RDB |
| 日志 | 记录每次更新操作,恢复时回放日志 | MySQL Binlog、Redis AOF、HBase HLog |
RDB 是快照,AOF 是日志。Redis 同时支持两种,也可以一起用。
相关卡片
概念卡:RDB 是什么?
一句话:RDB 就是一段时间点的内存完整快照(某一时刻的内存快照),像一个"照片",拍完就能随时恢复。
工作原理
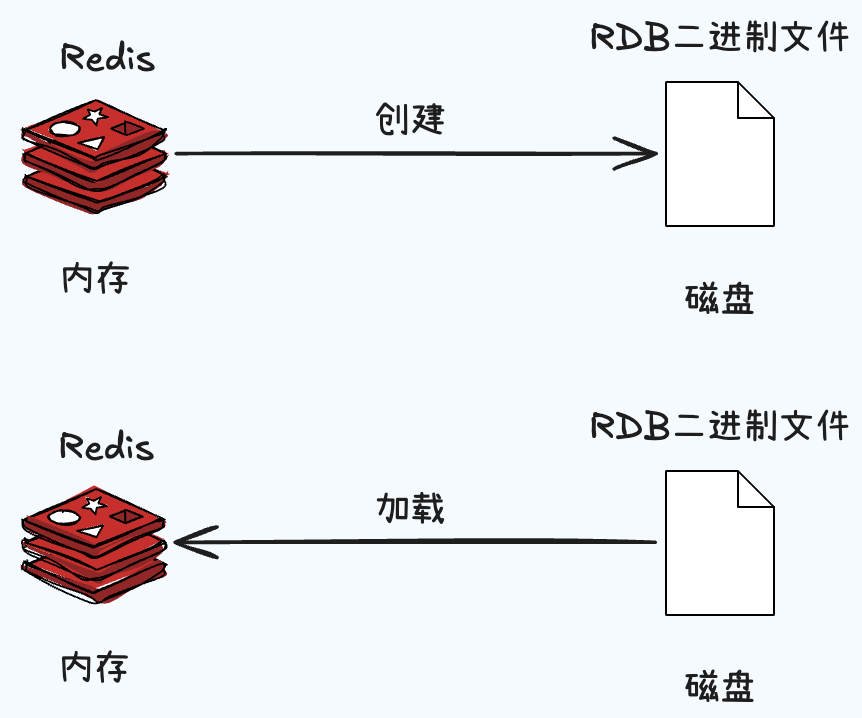
内存中的数据 ──(bgsave)──> 二进制快照文件(.rdb) ──(加载)──> 重启后恢复内存
Redis 通过一条命令将内存中的数据生成一个二进制快照文件,保存到硬盘。恢复时直接把 RDB 文件加载到内存即可。
RDB 的三种触发方式
1.手动 save(同步)
- 阻塞所有客户端命令,直到快照完成
- 数据量大时可能造成严重延迟
- 生产环境几乎不用
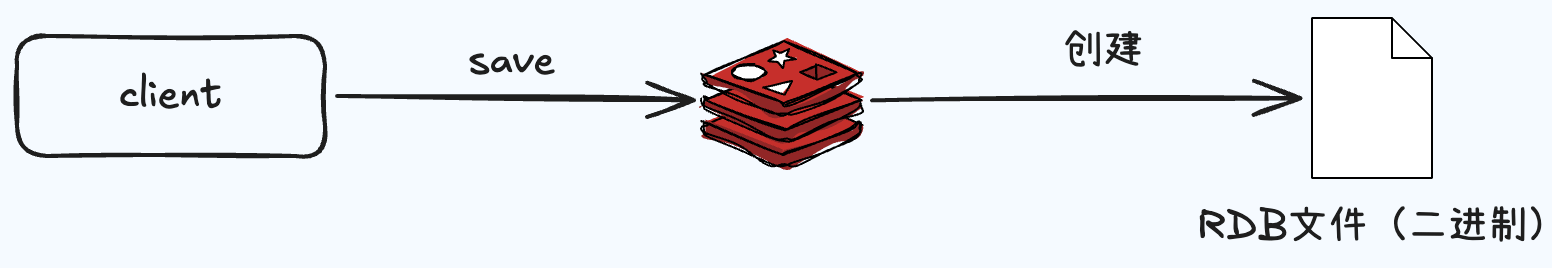
- 策略:如果存在老的 RDB 文件,新文件会替换旧文件
- 复杂度:O(n)
2.手动 bgsave(异步)
- 立即返回 OK,在后台子进程中执行
- 使用 Linux
fork()创建子进程生成 RDB - 子进程完成后通知主进程
- 生产环境推荐的手动方式
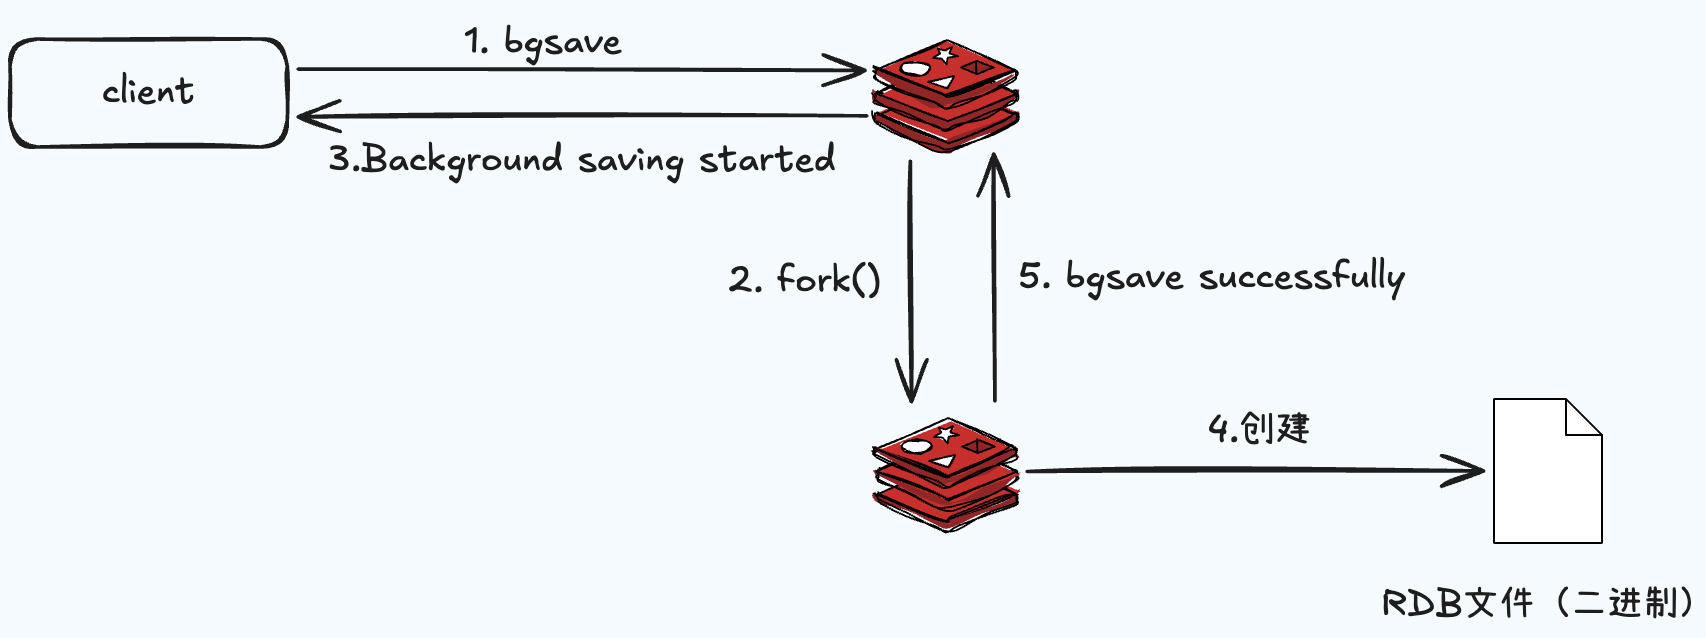
- 策略:如果存在老的 RDB 文件,新文件会替换旧文件
- 复杂度:O(n)
3.自动触发
满足以下任一条件就会自动执行 bgsave:
| save | seconds | changes | 说明 |
|---|---|---|---|
save 900 1 | 900 | 1 | 900 秒内至少有 1 次写操作 |
save 300 10 | 300 | 10 | 300 秒内至少有 10 次写操作 |
save 60 10000 | 60 | 10000 | 60 秒内至少有 10000 次写操作 |
默认三条都开启。生产环境通常全部注释掉,改为按需
bgsave。
缺点:频率过于频繁,我们无法控制,也可能造成硬盘压力。
RDB 的其他触发场景
- 主从复制:Master 做全量复制时自动生成 RDB
shutdown:Redis 优雅关闭时自动生成debug reload:重载配置时(等同于不清空内存的重启)
相关卡片
- ← #什么是持久化 持久化概述
- → #save vs bgsave 两种命令对比
- → #RDB 配置与实验 动手配置
对比卡:save vs bgsave
一句话:save 是同步的,会卡住所有请求;bgsave 是异步的,后台悄悄做。
对比表
| 维度 | save | bgsave |
|---|---|---|
| IO 类型 | 同步 | 异步 |
| 是否阻塞客户端 | 是,阻塞直到完成 | 否,立即返回 |
| fork 阻塞 | 不涉及 fork | fork 瞬间会短暂阻塞(微秒级) |
| 复杂度 | O(n) | O(n) |
| 额外内存 | 不消耗 | fork 产生 CoW 开销 |
| 适用场景 | 几乎不用 | 生产环境推荐 |
为什么 bgsave 不阻塞客户端?
bgsave 的核心是 Linux 的 fork():
- 主进程
fork()出一个子进程 - 子进程拥有主进程内存的只读副本(写时复制 Copy-On-Write)
- 子进程遍历内存,把数据写入 RDB 文件
- 主进程继续处理客户端请求
- 子进程完成后,将临时文件替换为正式 RDB 文件
⚠️
fork()的瞬间会短暂阻塞主线程(复制内存页表),但时间极短(微秒级),通常可以忽略。阻塞时间取决于内存总量。
相关卡片
- ← #RDB 是什么 RDB 触发方式
- → #RDB 配置与实验 实验验证
操作卡:RDB 配置与实验
一句话:关掉自动触发,手动 bgsave,看日志和文件。
RDB 核心配置
| 参数 | 默认值 | 说明 |
|---|---|---|
dbfilename | dump.rdb | RDB 文件名 |
dir | / | RDB 文件存放目录 |
rdbcompression | yes | 是否压缩 RDB 文件 |
rdbchecksum | yes | 是否校验 RDB 文件 |
stop-writes-on-bgsave-error | yes | bgsave 出错时是否停止写入 |
save | 900 1 | 300 10 | 60 10000 | 自动触发条件(生产建议注释掉) |
实验:save 阻塞 vs bgsave 不阻塞
Step 1:准备环境
# 启动 Redis(RDB 自动触发已注释)
redis-server redis-6379.conf

# 初始状态
redis-cli
127.0.0.1:6379> dbsize
(integer) 0
Step 2:插入测试数据(约 1000 万条,占用 1.17G)
for ((i=0; i<20000000; i+=10000)); do
    redis-cli EVAL "
    for j = $i, $((i+9999)) do
        redis.call('SET', 'key' .. j, 'value' .. j)
    end
    " 0
done
redis-cli
127.0.0.1:6379> dbsize
(integer) 10000000

# 查看内存
127.0.0.1:6379> info memory
# Memory
used_memory:1255165992
used_memory_human:1.17G
used_memory_rss:1288101888
used_memory_peak:1316694544
used_memory_peak_human:1.23G
used_memory_lua:791552
mem_fragmentation_ratio:1.03
mem_allocator:jemalloc-3.6.0
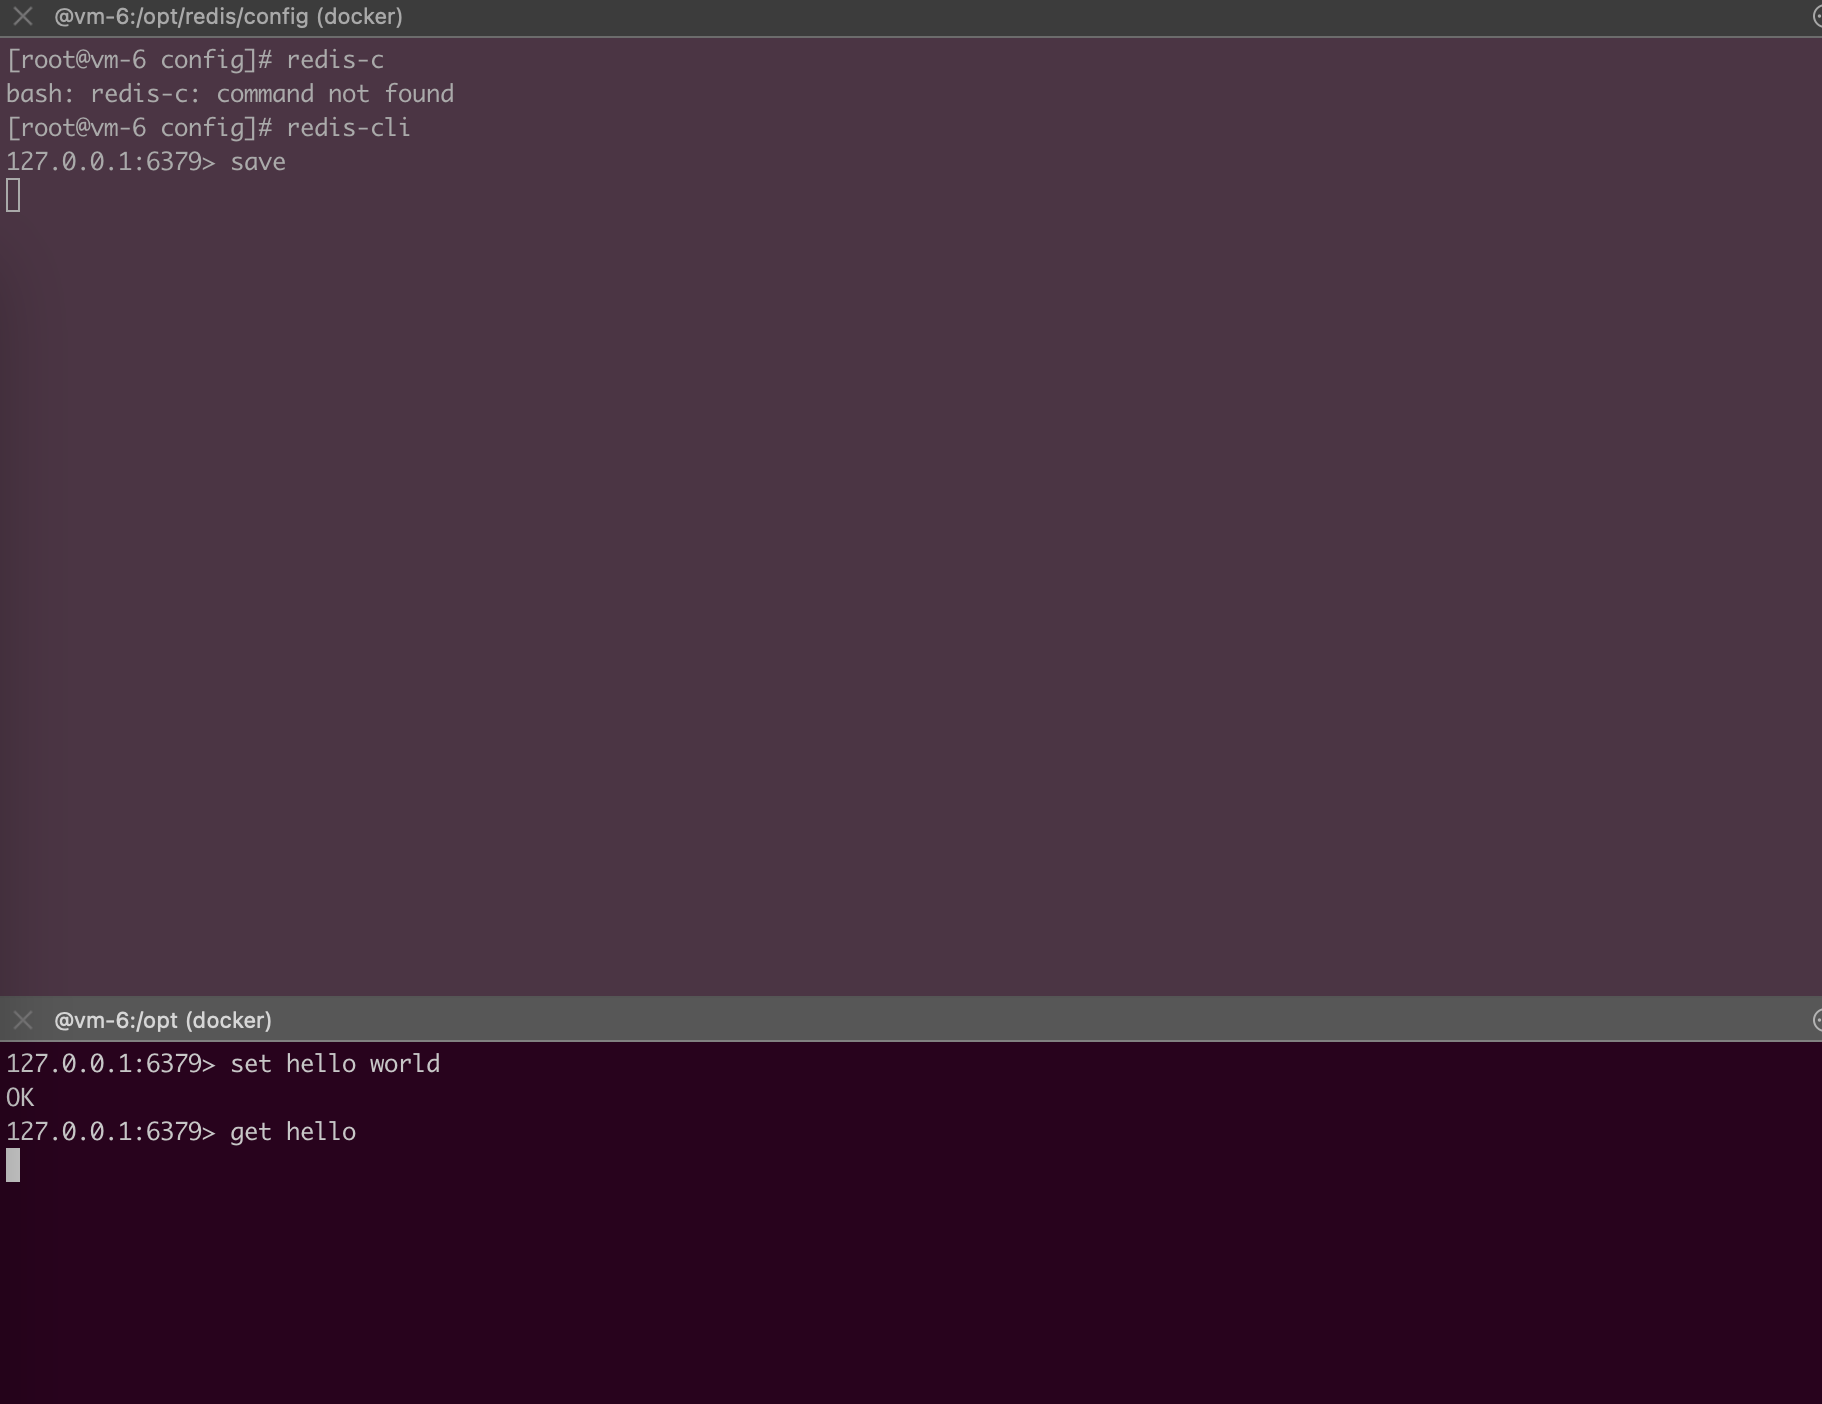
Step 3:验证 save 阻塞
准备两个终端:
# 终端 1:执行 save
redis-cli SAVE

# 终端 2:在终端 1 执行 save 期间发请求
redis-cli
127.0.0.1:6379> set hello world
OK
127.0.0.1:6379> get hello
# ← 这个 get 会被阻塞,直到 save 完成才返回
data 目录查看 RDB 文件:
cd /opt/redis/data
ll -lh
total 237M
-rw-r--r-- 1 root root 1.8K 11月 12 15:19 6379.log
-rw-r--r-- 1 root root 237M 11月 12 15:19 dump-6379.rdb
Step 4:验证 bgsave 不阻塞
# 终端 1:执行 bgsave
redis-cli BGSAVE
Background saving started

# 终端 2:正常读写不受影响
redis-cli
127.0.0.1:6379> get hello
"world"   # ← 立即返回,没有被阻塞
查看 bgsave 日志:
451:M 12 Nov 15:22:58.686 * Background saving started by pid 2393083
2393083:C 12 Nov 15:23:02.671 * DB saved on disk
2393083:C 12 Nov 15:23:02.676 * RDB: 0 MB of memory used by copy-on-write
451:M 12 Nov 15:23:02.688 * Background saving terminated with success
查看子进程:
ps -ef | grep redis- | grep -v redis-cli | grep -v grep
root         451       1  1 13:21 ?        00:01:49 redis-server *:6379
root     2393094     451 76 15:26 ?        00:00:00 redis-rdb-bgsave *:6379
查看临时文件:
ll -lh
total 292M
-rw-r--r-- 1 root root 2.9K 11月 12 15:28 6379.log
-rw-r--r-- 1 root root 237M 11月 12 15:27 dump-6379.rdb
-rw-r--r-- 1 root root  56M 11月 12 15:28 temp-2393102.rdb   # ← 临时文件
bgsave 先生成临时文件,完成后原子替换为正式文件,保证不会读到损坏的 RDB。
Step 5:验证自动触发
# 修改配置,60 秒内 5 次写操作触发
save 60 5

# 重启
redis-cli shutdown
redis-server redis/config/redis-6379.conf

# 60 秒内写 6 次
set hello world
set a b
set c d
set e f
set g h
set i j

# 查看日志,自动触发 bgsave
tail -f 6379.log
2393125:M 12 Nov 15:34:17.496 * 5 changes in 60 seconds. Saving...
2393125:M 15:34:17.509 * Background saving started by pid 2393137
2393137:C 15:34:21.197 * DB saved on disk
2393137:C 15:34:21.201 * RDB: 0 MB of memory used by copy-on-write
2393125:M 15:34:21.282 * Background saving terminated with success
相关卡片
- ← #RDB 是什么 RDB 原理
- ← #save vs bgsave 命令对比
概念卡:AOF 是什么?
一句话:AOF 是"操作日志",每写一条命令就记一笔,重启时按顺序重放就能恢复数据。
RDB 的问题
| 问题 | 说明 |
|---|---|
| 数据丢失窗口 | RDB 两次快照之间写入的数据会丢失(T2 ~ T4) |
| 全量开销大 | 每次都是 O(n) 全量快照,数据量大时耗时久 |
数据丢失场景:
| 时间点 | 事件 |
|---|---|
| T1 | 执行多个写命令 |
| T2 | 满足 RDB 自动创建条件 |
| T3 | 再次执行多个写命令 |
| T4 | 宕机 |
T3 ~ T4 之间的数据会丢失。
AOF 原理
客户端写命令 ──> Redis 缓冲区 ──(fsync)──> 磁盘 AOF 文件
重启时 ──> 重放 AOF 文件中的所有命令 ──> 恢复数据
AOF 记录的是每一条写命令,而不是数据快照。恢复时逐条执行这些命令,就能重建完整数据。
AOF 三种刷盘策略
Redis 执行写命令时,先把命令写入缓冲区,再根据配置的策略刷新到磁盘:
| 策略 | 行为 | 数据安全性 | 性能 |
|---|---|---|---|
| always | 每条命令立即 fsync 到磁盘 | 零丢失 | 最差(磁盘只有几百 TPS) |
| everysec(推荐) | 每秒 fsync 一次 | 最多丢 1 秒数据 | 良好 |
| no | 由操作系统决定何时刷盘 | 不可控 | 最好 |
生产推荐
everysec:性能和安全性最好的折中。最多丢失 1 秒数据,但性能接近直接写入。
相关卡片
- ← #RDB 是什么 了解 RDB 后再看 AOF
- → #AOF 重写 AOF 文件会越来越大怎么办?
- → #RDB vs AOF 选择 到底用哪个?
概念卡:AOF 重写
一句话:AOF 文件会越来越大,重写就是"精简版"——去掉无效命令,只保留最终结果。
为什么要重写
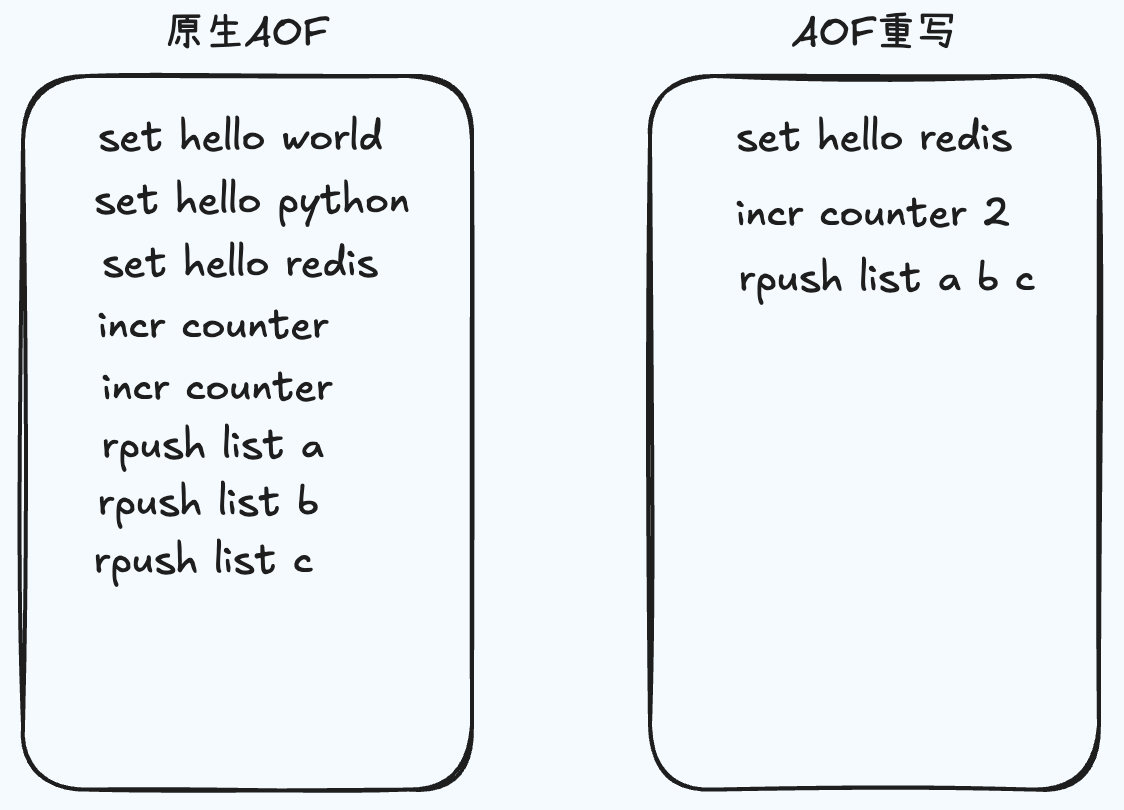
AOF 记录了每一条写命令,随着时间推移文件会膨胀:
SET key1 val1
SET key1 val2     ← key1 被覆盖了,第一条是无效的
INCR counter      → 1
INCR counter      → 2
INCR counter      → 3
SET counter 3     ← 三条 INCR 可以合并成一条 SET
重写后:
SET key1 val2
SET counter 3
重写的两个好处:
- 减少磁盘占用
- 加速恢复速度(恢复时命令少了)
重写机制:bgrewriteaof
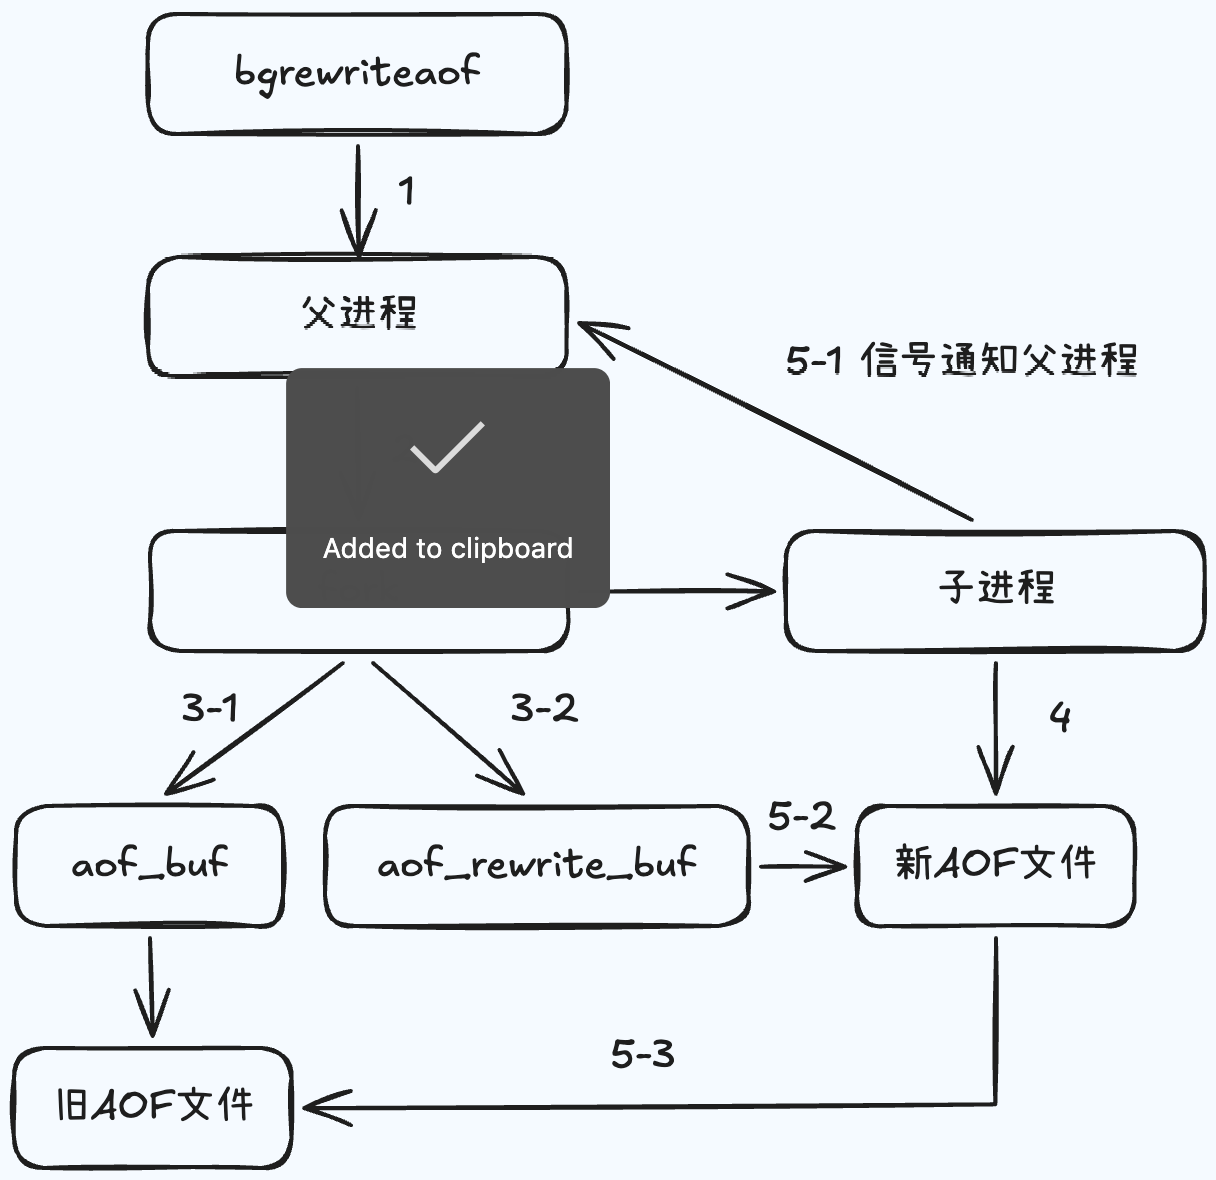
和 bgsave 一样,AOF 重写也使用 fork() 创建子进程:
- 主进程
fork()子进程 - 子进程从内存中读取最新数据,生成精简的 AOF 文件(临时文件)
- 主进程继续处理请求,同时将新写入的命令追加到旧 AOF 和重写日志
- 子进程完成后,主进程将重写日志中的命令合并到新 AOF
- 替换旧 AOF 文件
AOF 重写触发条件
需要同时满足两个条件:
| 配置项 | 默认值 | 说明 |
|---|---|---|
auto-aof-rewrite-min-size | 64MB | AOF 文件至少这么大才考虑重写 |
auto-aof-rewrite-percentage | 100% | AOF 文件大小相比上次重写增长超过 100% |
统计项:
| 统计项 | 含义 |
|---|---|
aof_current_size | AOF 当前尺寸(字节) |
aof_base_size | AOF 上次启动和重写时的尺寸(字节) |
判断逻辑:
aof_current_size > auto-aof-rewrite-min-size
AND
(aof_current_size - aof_base_size) / aof_base_size > auto-aof-rewrite-percentage
流程
相关卡片
- ← #AOF 是什么 AOF 原理
- → #AOF 演示 动手操作
- → #fork 与子进程优化 重写也涉及 fork
操作卡:AOF 演示
一句话:开启 AOF → 写几条数据 → 看文件 → 触发重写 → 再看文件。
开启 AOF
# 查看当前配置
127.0.0.1:6379> config get appendonly
1) "appendonly"
2) "no"

# 动态开启
127.0.0.1:6379> config set appendonly yes
OK

# 持久化到配置文件中
127.0.0.1:6379> config rewrite
OK
127.0.0.1:6379> exit
写入测试数据
127.0.0.1:6379> set hello world
OK
127.0.0.1:6379> set hello redis
OK
127.0.0.1:6379> set hello python
OK
127.0.0.1:6379> incr counter
(integer) 1
127.0.0.1:6379> incr counter
(integer) 2
127.0.0.1:6379> rpush list a
(integer) 1
127.0.0.1:6379> rpush list b
(integer) 2
127.0.0.1:6379> rpush list c
(integer) 3
查看 AOF 文件
Redis 4.0+ 使用文件重写机制(multi-part AOF),文件存放在 appendonlydir/ 目录下:
root@vm-1:/opt/redis/data# ll
total 505668
drwxr-xr-x  3 root   root        4096 Jul  1 15:17 ./
drwxrwxr-x 11 ubuntu ubuntu      4096 Jul  1 11:38 ../
-rw-r--r--  1 root   root        4762 Jul  1 15:17 6379.log
drwxr-xr-x  2 root   root        4096 Jul  1 15:15 appendonlydir/
-rw-r--r--  1 root   root   517777890 Jul  1 15:17 dump-6379.rdb

root@vm-1:/opt/redis/data# ll appendonlydir/
total 505664
drwxr-xr-x 2 root root      4096 Jul  1 15:15 ./
drwxr-xr-x 3 root root      4096 Jul  1 15:17 ../
-rw-r--r-- 1 root root 517777890 Jul  1 15:15 appendonly.aof.1.base.rdb    # 基础 RDB
-rw-r--r-- 1 root root       279 Jul  1 15:17 appendonly.aof.1.incr.aof    # 增量 AOF
-rw-r--r-- 1 root root       102 Jul  1 15:15 appendonly.aof.manifest      # 文件清单
Redis 4.0+ 的文件结构变化:不再是一个
appendonly.aof文件,而是appendonlydir/目录下的一组文件。base.rdb是快照,incr.aof是增量日志,manifest描述文件顺序。
手动触发 AOF 重写
127.0.0.1:6379> bgrewriteaof
Background append only file rewriting started
重写后查看文件:
root@vm-1:/opt/redis/data/appendonlydir# ll
total 505660
drwxr-xr-x 2 root root      4096 Jul  1 15:21 ./
drwxr-xr-x 3 root root      4096 Jul  1 15:21 ../
-rw-r--r-- 1 root root 517777927 Jul  1 15:21 appendonly.aof.2.base.rdb    # ← 编号变了,文件更新了
-rw-r--r-- 1 root root         0 Jul  1 15:21 appendonly.aof.2.incr.aof    # ← 增量文件清空
-rw-r--r-- 1 root root       102 Jul  1 15:21 appendonly.aof.manifest
重写后增量 AOF 文件变为 0,因为所有有效命令已经合并到新的 base.rdb 中。后续写操作会生成新的
incr.aof。
相关卡片
- ← #AOF 重写 重写原理
- → #RDB vs AOF 选择 到底用哪个?
对比卡:RDB vs AOF 怎么选?
一句话:RDB 快但可能丢数据,AOF 安全但文件大。生产环境两个都开,RDB 做备份,AOF 做恢复。
对比表
| 维度 | RDB | AOF |
|---|---|---|
| 持久化方式 | 快照(完整数据) | 日志(操作命令) |
| 恢复速度 | 快(直接加载二进制文件) | 慢(逐条回放命令) |
| 数据安全性 | 差(两次快照间的数据会丢) | 好(最多丢 1 秒) |
| 磁盘占用 | 小(压缩后的二进制) | 大(每条命令都记录) |
| CPU 开销 | 低(偶尔 bgsave) | 高(持续追加 + 重写) |
| 适用场景 | 容灾备份、大数据集恢复 | 高可用、低延迟恢复 |

RDB 最佳策略
- 推荐关闭自动触发(注释掉所有
save行) - 按天/小时手动
bgsave做定期备份 - 主从模式下,从节点推荐开启 RDB(用于复制)
AOF 最佳策略
- 推荐开启,策略设为
everysec - 让 Redis 自动管理 AOF 重写(默认配置即可)
- 监控 AOF 文件大小,必要时手动
bgrewriteaof
两者都开
- Redis 重启时优先用 AOF 恢复(数据更全)
- RDB 作为 AOF 的兜底备份
通用建议
- 分片:数据量大时做水平分片
- 定位:明确 Redis 是缓存还是持久存储
- 监控:硬盘、内存、负载、网络
- 容量:确保内存足够放下数据集
相关卡片
- ← #RDB 是什么 RDB 详情
- ← #AOF 是什么 AOF 详情
- → #fork 与子进程优化 两者都有 fork 开销
故障卡:fork 与子进程优化
一句话:bgsave 和 bgrewriteaof 都要 fork(),fork 的开销和内存量成正比,内存越大越慢。
fork 的本质
fork()是同步操作,复制的是内存页表而非整个内存- 大部分情况下速度非常快(微秒级)
- 但如果内存很大或系统负载高,fork 可能变得很慢,甚至阻塞主线程
如何查看 fork 耗时
127.0.0.1:6379> info persistence | grep latest_fork
latest_fork_usec:12345
latest_fork_usec 单位是微秒,超过 100000(100ms)就需要关注了。
fork 开销的三大维度
1.CPU
- 开销来源:RDB/AOF 文件生成是 CPU 密集型(内存 → 磁盘序列化)
- 优化:
- 不要把 Redis 进程绑定到单个 CPU 核心
- 不要和 CPU 密集型应用部署在同一台机器
2.内存(CoW 开销)
- 开销来源:fork 后子进程只读父进程内存,父进程写数据时触发 Copy-On-Write,产生额外内存
- 优化:
- 关闭透明大页:
echo never > /sys/kernel/mm/transparent_hugepage/enabled - 设置
vm.overcommit_memory=1(允许 fork 时超额分配内存) - 控制
maxmemory,不要让内存无限增长
- 关闭透明大页:
3.磁盘 IO
- 开销来源:AOF/RDB 文件写入
- 优化:
- 不要用高 IO 负载的服务器同时跑 Redis
- 设置
no-appendfsync-on-rewrite yes(重写期间暂停 fsync,减少磁盘压力) - 使用 SSD 提升写入性能
- 结合
iostat、iotop分析磁盘瓶颈
降低 fork 频率的方法
| 方法 | 说明 |
|---|---|
| 放宽 AOF 重写触发阈值 | 增大 auto-aof-rewrite-min-size |
| 减少不必要的全量复制 | 优化主从配置,利用部分复制 |
| 控制实例内存上限 | 合理设置 maxmemory |
| 使用物理机或高效虚拟化 | KVM/Xen 的 fork 支持比某些云平台好 |
AOF 追加阻塞

相关卡片
- ← #RDB 是什么 bgsave 涉及 fork
- ← #AOF 重写 bgrewriteaof 也涉及 fork
- → #RDB vs AOF 选择 两者都有 fork 开销